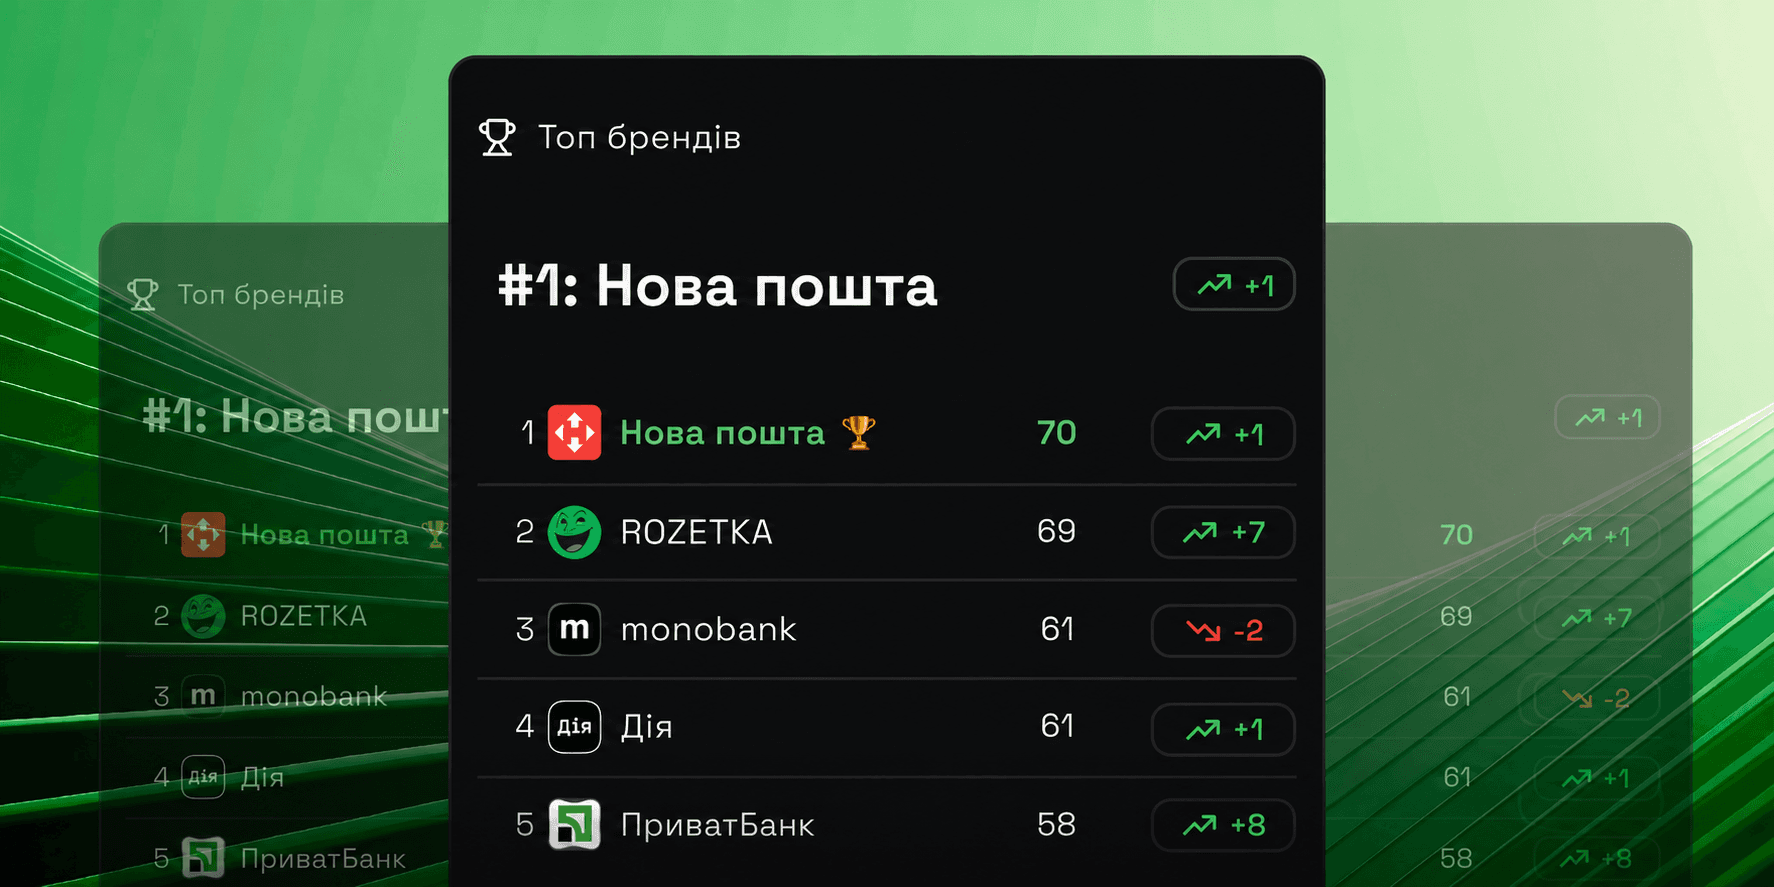
Одна модель ШІ може створити відчуття безпеки, якого насправді немає. ChatGPT, Gemini та Perplexity навчаються на різних масивах даних, по-різному добирають джерела й мають власні географічні та тематичні упередження.
Якщо бренд бачить хорошу відповідь лише в одному сервісі, це ще не означає, що він видимий у всьому ШІ-пошуку. Справжня картина з’являється лише тоді, коли моделі порівнюються на однакових промптах.
1. Одна модель дає викривлену картину
Уявіть, що одна модель цитує ваш бренд у 90% відповідей, а інша — лише в 20%. Середнє без розрізу приховає цей ризик, а команда помилково вирішить, що видимість стабільна.
Різниця може виникати через джерела, яким довіряє модель, її формат відповіді або регіональний контекст. Саме тому у звіті потрібно зберігати не лише підсумок, а й модель-джерело спостереження.
2. Покрийте всю GEO-воронку
На етапі обізнаності людина питає, що існує на ринку; на етапі дослідження — як працюють рішення; далі порівнює варіанти й переходить до покупки. Одна модель може бути сильною в поясненнях, але слабкою у локальних рекомендаціях або порівняннях.
Збирайте промпти для кожного етапу й перевіряйте їх у кількох моделях. Так команда бачить не просто рейтинг сервісів, а місця, де бренд зникає перед конкретним рішенням клієнта.
3. Перетворіть різницю моделей на дію
Почніть із розриву: де видимість низька, тональність негативна або конкурент отримує цитування замість вас. Потім подивіться на джерела саме цієї моделі — вони можуть відрізнятися від джерел лідера в іншому сервісі.
Для однієї моделі потрібна сторінка порівняння, для іншої — структурована відповідь, локальна згадка чи сильніше зовнішнє джерело. Рекомендації GEOgrowth мають виходити з цього конкретного розриву.
Висновок. Мульти-модельне відстеження — це не зайві графіки. Воно показує, де саме бренд має вплив, де втрачає його і яку частину ШІ-воронки потрібно посилити першою.